
Hunyuan3D no lee tu prompt: en imagen a 3D, el brief completo es la foto
En los modos de imagen a 3D de Hunyuan3D el campo de texto no se lee: el propio contrato del modelo dice que no acepta prompt. Todo el control que tienes está en cómo preparas la imagen de entrada. Las mallas parten desde 600 créditos en Rapid y 1000 en Pro.
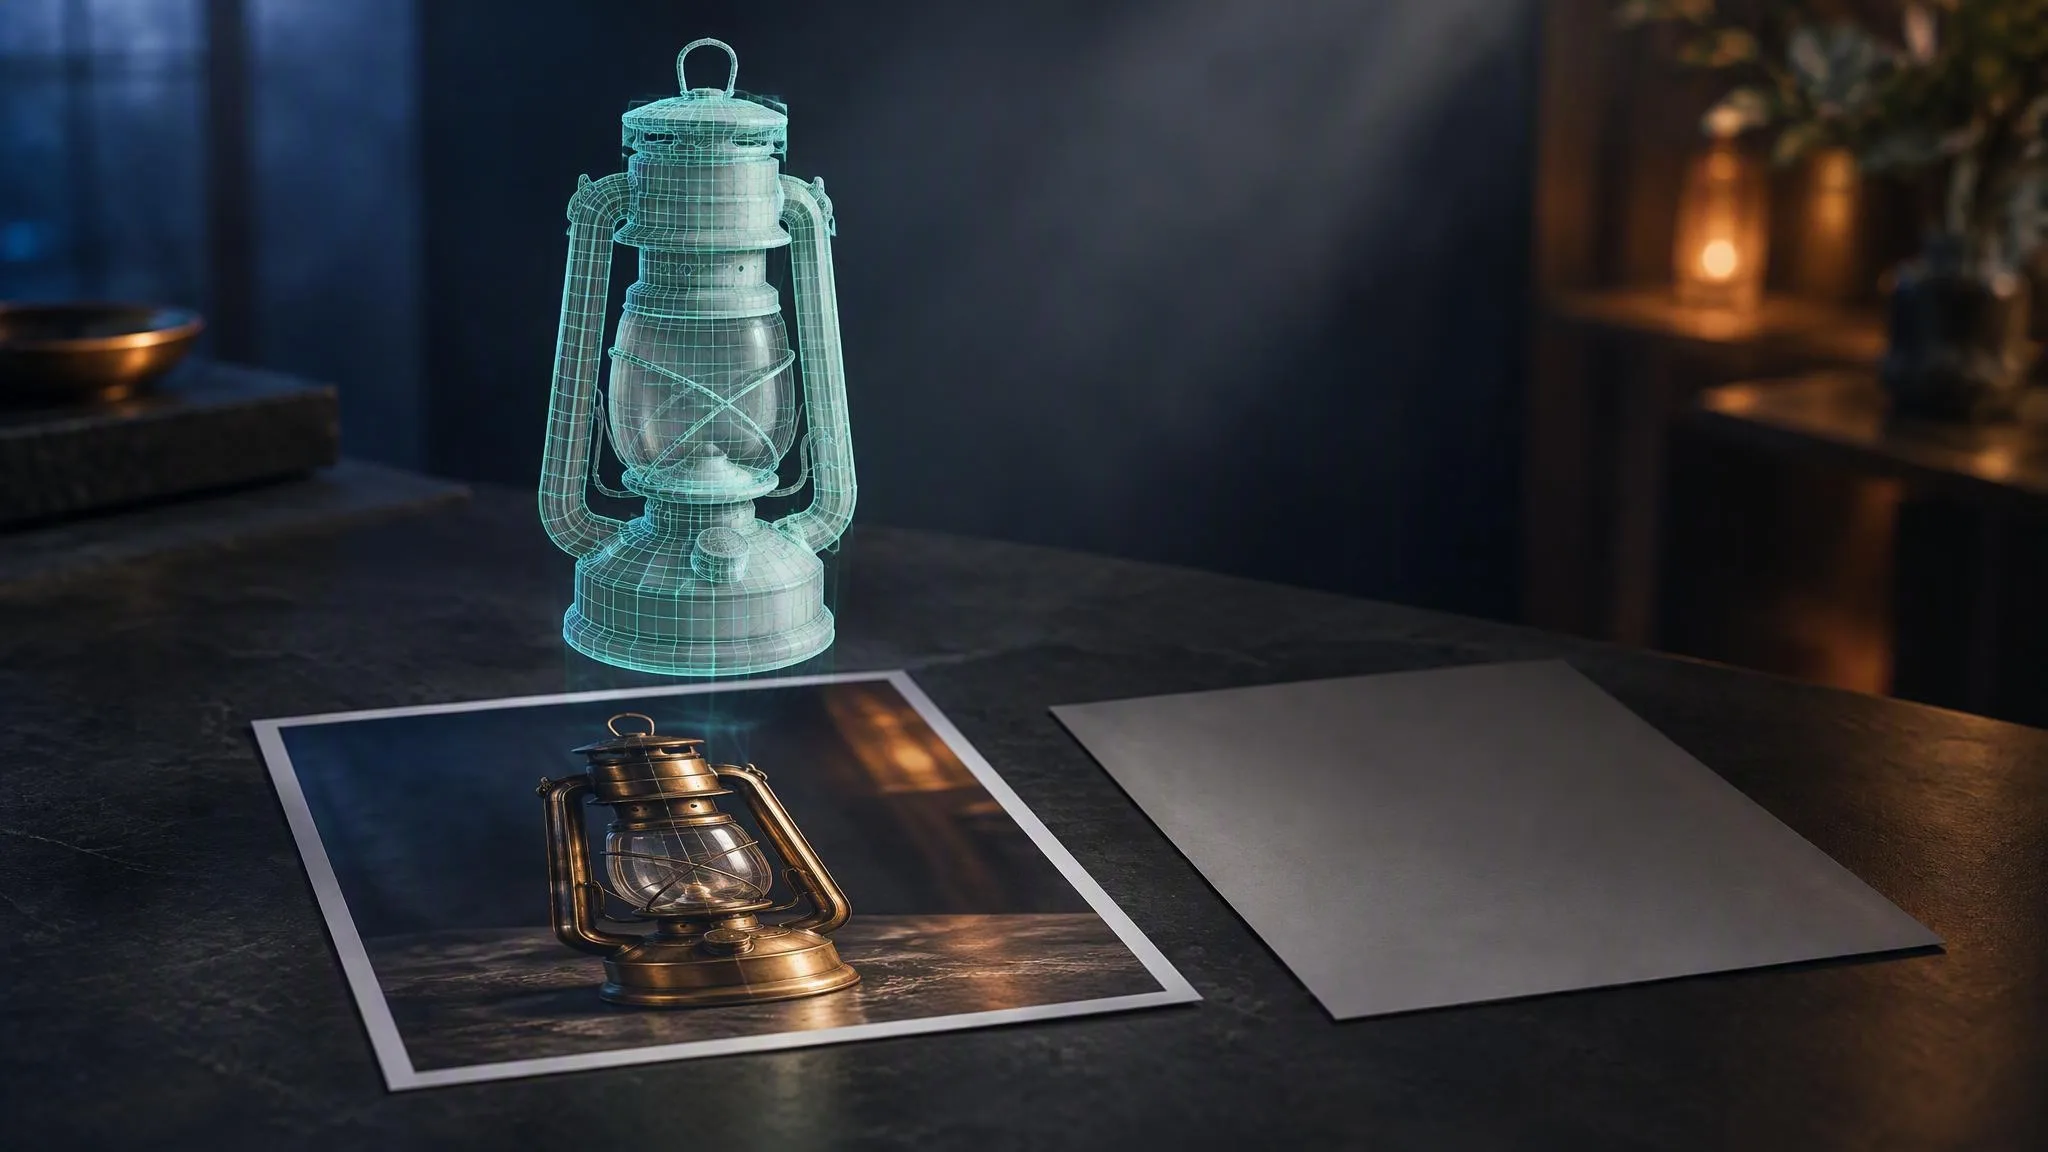
Hunyuan3D es el generador 3D de Tencent y la única familia 3D del catálogo de LUVI. Viene en dos niveles, Rapid y Pro, cada uno con un modo de imagen a 3D y otro de texto a 3D. Lo que conviene saber antes de gastar: en los modos de imagen a 3D, el contrato del modelo en LUVI informa que no acepta ningún prompt. Lo que escribas ahí no se envía. La instrucción completa es la imagen de entrada.
¿Dónde está entonces el control?
En la foto que subes y en cinco propiedades suyas. Nuestro manual para esta familia lo dice sin rodeos: imagen a 3D ignora tu texto, y la geometría sale de los píxeles, no de las palabras. Lo que da forma a la malla es esto:
- Un solo objeto aislado. No una escena, ni un producto con accesorios al lado. El modelo reconstruye lo que interpreta como el sujeto.
- Un fondo liso y limpio. Cualquier cosa cargada detrás del objeto compite por volverse parte de él.
- Luz plana y pareja. Las sombras duras se leen como forma y los brillos quemados como material.
- Una vista casi frontal, más o menos dentro de veinte grados respecto de la altura de los ojos. Los ángulos extremos esconden las superficies que necesita la reconstrucción.
- Pose en T o en A para personajes, para que las extremidades queden separadas y no encimadas al cuerpo.
Si te salen extremidades fusionadas, una espalda plana o una malla que parece tallada en su propia sombra, la solución es una foto nueva o un render limpio, nunca un prompt más largo.
¿El modo de texto a 3D sí lee el prompt?
Sí. Esa es la diferencia entre los dos modos, y el contrato del modelo lo dice claro: tencent/hunyuan3d-pro/text-to-3d acepta prompt y tencent/hunyuan3d-pro/image-to-3d no.
Conviene saber en cuál estás, porque los dos tipos de falla no se parecen en nada. Un resultado flojo en texto a 3D significa que la descripción fue demasiado vaga. Un resultado flojo en imagen a 3D significa que en la foto había algo que no querías modelar.
De ahí sale un flujo práctico: si tienes una idea pero no una referencia limpia, genera primero la referencia con un modelo de imagen, con fondo liso y vista frontal, y mete eso en imagen a 3D. Así consigues el control de un prompt de texto y la calidad de reconstrucción de una entrada limpia.
¿Qué hacen los parámetros?
Son cuatro, y dos cambian lo que pagas.
generate_type,NormaloGeometry, en el nivel Pro.Normaldevuelve una malla texturizada;Geometry, un modelo blanco sin textura. Es la forma más barata de comprobar que la forma está bien antes de pagar por la textura.enable_pbr, apagado por defecto. Genera mapas metálicos, de rugosidad y normales junto con la malla; Tencent describe esa parte de la línea como "Physically-Based Rendering (PBR) Texture Synthesis", con "simulación de materiales basada en física para generar texturas con una interacción de luz fotorrealista". No tiene efecto cuandogenerate_typeesGeometry.face_count, de 40,000 a 1,500,000 polígonos en el nivel Pro. Los flujos de juego y de RA suelen querer el extremo bajo; un activo protagonista para un render aguanta el alto.format, en el nivel Rapid: GLB, OBJ, USDZ, FBX, STL o MP4. GLB es el valor por defecto y el que muestra el visor de LUVI.
¿Cuánto cuesta una malla?
Es un precio fijo por generación, y la configuración lo mueve. Verificado el 22 de septiembre de 2026:
- Rapid, GLB sin PBR: 600 créditos.
- Pro,
Geometry(sin textura): 1000 créditos. - Pro,
Normal(texturizada), sin PBR: 1400 créditos. - Pro,
Normalcon PBR y una malla de 500,000 caras: 1800 créditos.
La consecuencia práctica es un ensayo barato. Corre la forma en Geometry primero, míralo, y paga la textura y el PBR solo cuando la silueta sea la que querías.
Cómo lo verificamos
- Modelos:
tencent/hunyuan3d-pro/image-to-3d,/text-to-3dy el parhunyuan3d-rapid. - Ajustes:
generate_typeNormal y Geometry,enable_pbrencendido y apagado,face_counten su piso de 40,000 y en 500,000, los seis formatos de salida de Rapid. - Fecha y qué se leyó: 22 de septiembre de 2026. Los contratos de los modelos y las estimaciones de créditos en LUVI, la guía de prompts que LUVI aplica a esta familia, y el repositorio de Tencent enlazado abajo.
- Resultados: el contrato informa
acceptsPrompt: falseen los dos modos de imagen a 3D ytrueen los dos de texto a 3D. Las cifras de créditos son las de arriba, cada una confirmada contra las páginas de modelo en vivo. - Limitaciones: No se generó ninguna malla para este artículo, así que no afirma nada sobre la calidad del resultado. Los repositorios públicos de Tencent documentan la línea 2.x; los modos de LUVI son los niveles Pro (v3.1) y Rapid, así que las reglas de preparación de imagen de arriba vienen de nuestro manual y no de una página del proveedor.
En LUVI
Elige el modo antes que el nivel. Suelta tu imagen en Hunyuan 3D Rapid Image-to-3D para un primer vistazo, y sube a Pro cuando la entrada esté limpia y quieras el presupuesto de polígonos y los mapas PBR.
La caja de prompt seguirá ahí en los modos de imagen, y el botón de la pluma seguirá aplicando la guía de la familia, pero en esta familia el consejo de la guía es sobre la foto y no sobre la frase. Esa es la respuesta honesta, y es la que da LuviTransLex.
Si tu imagen de referencia necesita limpieza primero, las familias de imagen de la misma cuenta pueden hacerlo, y toda la cadena se puede armar como flujo de trabajo o manejar desde Claude con el conector de LUVI.
¿Recién llegas? Crea una cuenta de LUVI y gasta tus primeros 600 créditos en una malla Rapid hecha con una foto que ya tengas: te dirá más sobre tu foto que sobre el modelo.
Fuentes
- Hunyuan3D-2.1. Tencent Hunyuan, repositorio del proyecto (en inglés). Consultado el 22 de septiembre de 2026.
- Hunyuan3D. Tencent, sitio del producto (en inglés). Consultado el 22 de septiembre de 2026.
Más de Guías
- Cómo usar MiniMax H3: el prompt es un documento de tres campos, no una descripciónMiniMax H3 lee el prompt como tres campos con nombre, y si dejas vacío uno de sonido lo llena con audio que no pediste. Cómo armar el documento, la cámara, el diálogo y los valores por defecto que sorprenden, desde 2080 créditos por ocho segundos.
- Cómo cambiar una sola palabra en una imagen terminada con GPT Image 2.5 sin tocar lo demásPara corregir un precio, una fecha o un nombre en una imagen terminada, usa una edición de GPT Image 2.5: escribe el cambio con el texto viejo y el nuevo entre comillas y luego enumera lo que debe quedarse. Todo el cuadro se redibuja: lo demás se ve igual, aunque no idéntico. Desde 49 créditos.
- ¿Claude puede generar imágenes y videos? Por sí solo no: así se hace con un conectorClaude no genera fotos, ilustraciones ni video filmado por su cuenta; lo dice el centro de ayuda de Anthropic. Si agregas LUVI Creator como conector personalizado, Claude ejecuta más de 200 modelos de imagen, video, audio y 3D con tus créditos de LUVI, y ves el precio antes de cada generación.