LUVI Creator ist eine Web-Plattform, auf der du mit 223 KI-Modellen aus 30 Familien Videos, Bilder, Audio und 3D generierst – mit einem Konto, bezahlt in Credits. Parallele Generierungen, wiederverwendbare Referenzen und Workflows sparen Zeit, Prompting-Guides für 18 Familien schützen das Ergebnis.
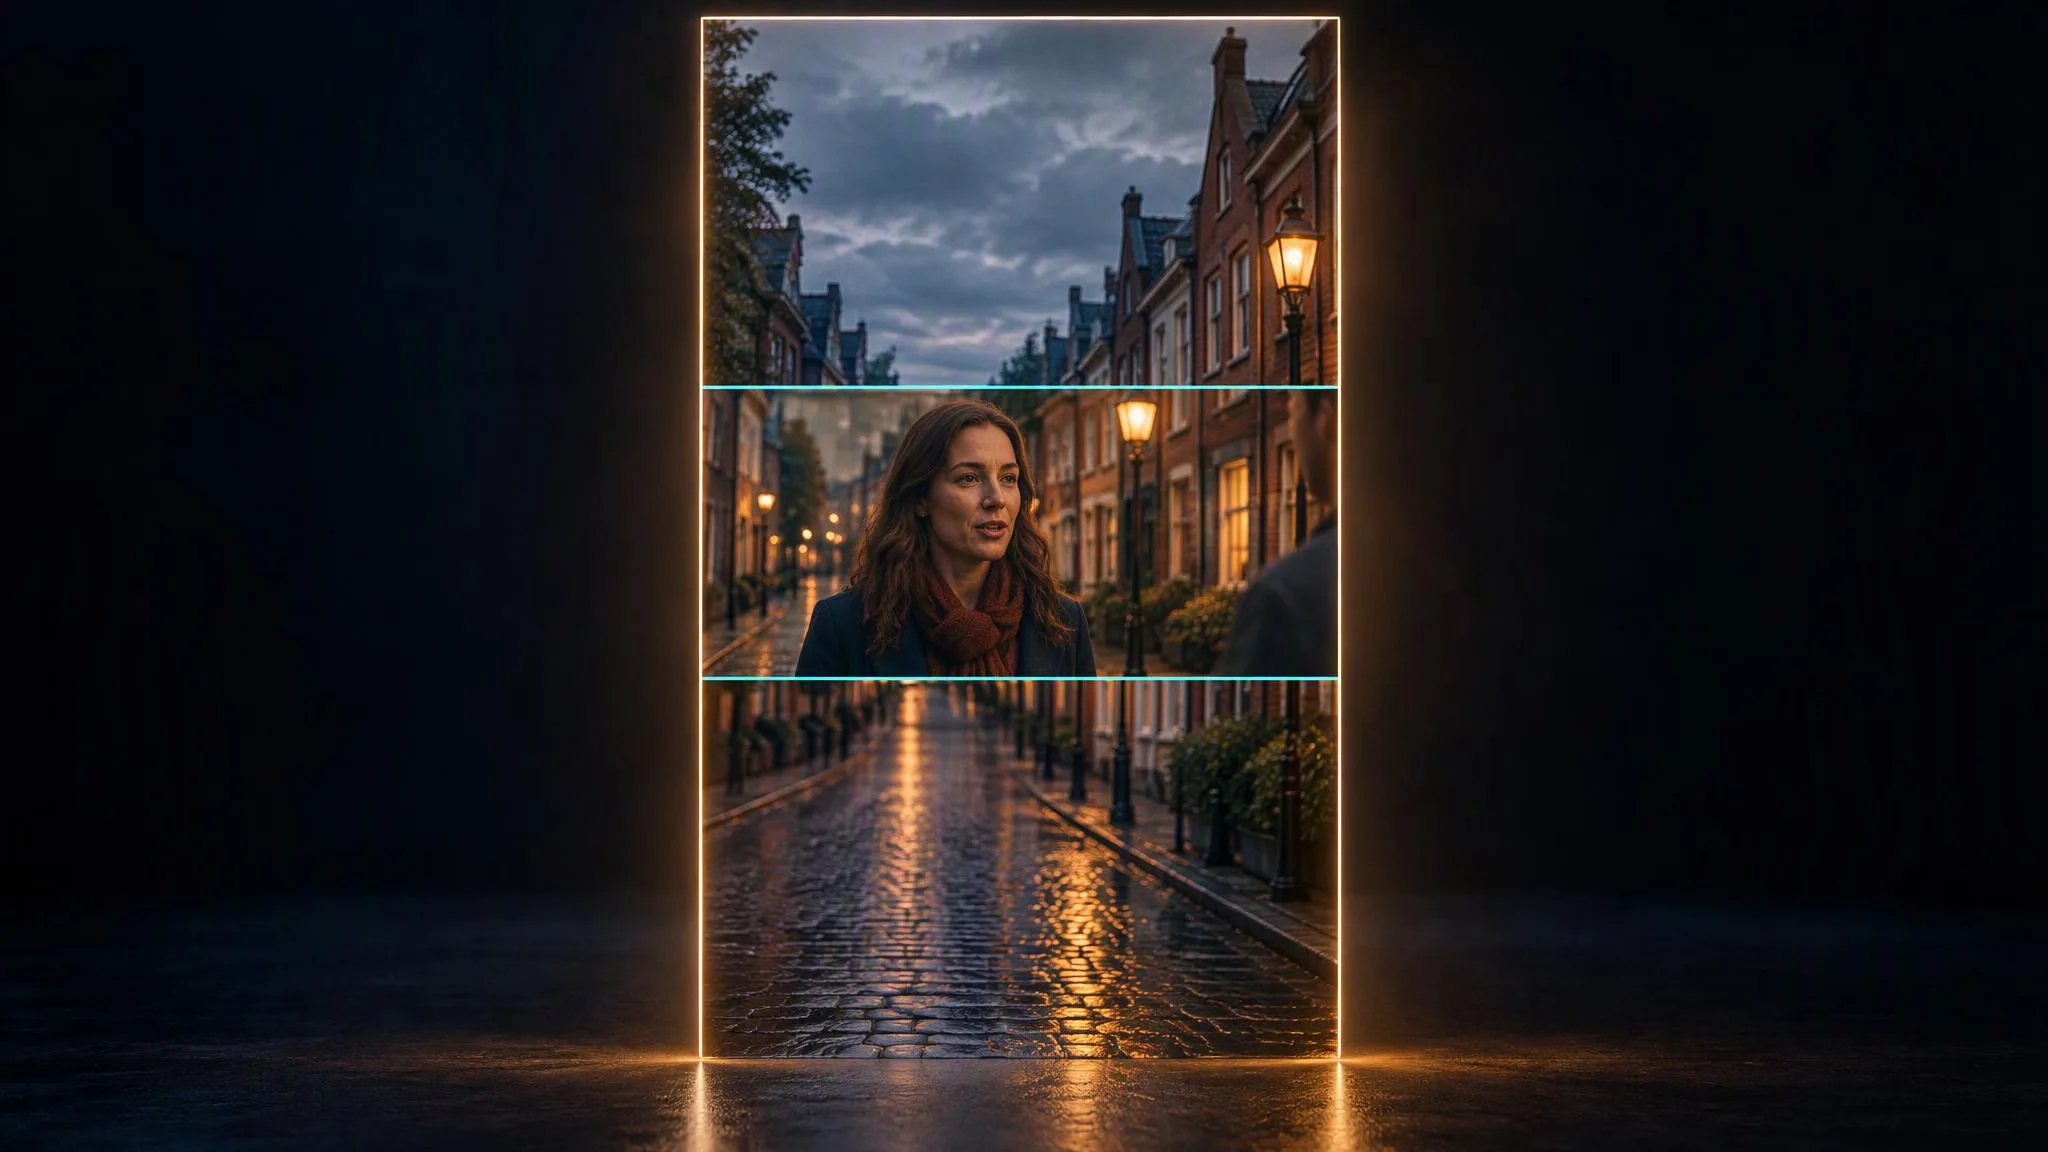
Luma Ray 3.2 Reframe behält dein komplettes 16:9-Bild und generiert für 9:16 das fehlende Bild darüber und darunter. Auf LUVI kostet das 264 Credits pro Sekunde Quellvideo in 720p. Halte jeden Clip bei höchstens 10 Sekunden und bleib im Hochformat bei 720p, denn 1080p bietet Luma dort noch nicht an.
Luma Uni 1 erzeugt und bearbeitet Bilder nach klaren Beschreibungen: Schreib, was du willst, nie, was du nicht willst, und nenn das Licht. Auf LUVI kostet ein Bild 89 Credits, eine Bearbeitung 96, mit Uni 1 Max 220 und 227. Luma empfiehlt 80 bis 250 Wörter pro Bild und 30 bis 100 pro Bearbeitung.
Auf dem Workflow-Canvas von LUVI hängt der Pose-Knoten eine von 740 Körperbeschreibungen an den durchlaufenden Text, der Einstellung-Knoten eine von 600 statischen Kompositionen und der Stil-Knoten einen von 1060 Prompt-Lab-Cues. Die Knoten kosten nichts, bezahlt wird nur der Generator.
Seedream 5.0 Pro und Flash zerlegen ein Bild in ein Basisbild und bis zu 16 transparente PNG-Ebenen. Ohne Prompt trennen sie alle Hauptelemente, mit Prompt wählst du gezielt aus, auch per Koordinaten. Bei Flash zeigt die Schätzung bis zu 612 Credits; abgerechnet wird nach den gelieferten Ebenen.
MiniMax Lyrics Generation schreibt den Songtext für 20 Credits. Gesungen wird er entweder von MiniMax Music 3.0 (300 Credits, ein Track bis fünf Minuten) oder von Suno v6 im Custom-Modus (264 Credits für zwei Versionen). Die Abschnitts-Tags des Textes lassen sich direkt übernehmen.
Auf LUVI nehmen Suno v6, v6 mini und v6 wild dieselben elf Einstellungen an und kosten gleich viel: 264 Credits für zwei Versionen. Du wählst nur die Engine: v6 für ausgearbeitete Songs, v6 mini für schnelle Entwürfe, v6 wild für weniger vorhersehbare Ideen.
Vom 25. September bis 17. Oktober 2026 sind auf LUVI 22 Modelle aus acht Familien dazugekommen: Luma Ray 3.2 und Uni 1, HI3D, die Ebenenzerlegung von Seedream 5.0, Nano Banana 2.1, Suno v6, MiniMax Music 3.0 und MiniMax Lyrics. Die Preise beginnen bei 20 Credits für einen Songtext.
Nano Banana 2.1 liest nur Fließtext: Beschreib, was im Bild sein soll, nie, was fehlen soll, und stell Größe und Format in den Reglern ein. Auf LUVI kostet Text zu Bild in 1k ab 80 Credits, die Bearbeitung ab 83 und der Modus, der aus einem Video ein Standbild macht, ab 400.
Ein Workflow-Graph wird geprüft, bevor auch nur ein Credit fließt: ein unbekannter Port, ein Audioplatz mit einem Video, eine leere Pflichteingabe oder ein Zyklus sind Fehler, und ein Graph mit Fehlern läuft nicht. Das ist der echte Unterschied zum Schritt-für-Schritt-Generieren.
Die nächsten Alternativen zu Higgsfield sind Multi-Modell-Plattformen: Krea, Magnific (früher Freepik AI), OpenArt, Pollo AI und LUVI Creator. Alle fünf bieten Veo 3.1 und Seedance 2.5. Unterschiede gibt es bei Kling 4.0, Tarifbindung, Preisanzeige vorab und der Anbindung an Claude oder ChatGPT.
Ja, wenn dein ChatGPT-Tarif eigene MCP-Server erlaubt: LUVI unter Plugins hinzufügen, mit deinem LUVI-Konto anmelden, und ChatGPT kann Veo 3.1, Kling, Seedance 2.5 und Nano Banana mit deinen Credits kalkulieren und starten. Nenn LUVI und das Modell beim Namen und lass dir zuerst den Preis geben.
Higgsfield, Krea, Magnific (früher Freepik), OpenArt, Pollo AI und LUVI Creator bieten Kling, Veo, Seedance und Nano Banana unter einem Konto an. Unterschiede gibt es bei den genauen Versionen (LUVI hat kein Kling 4.0), bei den Modellen im Tarif und beim Preis vor dem Start.
Websites, die mit KI Bilder und Videos erstellen, gibt es in drei Arten: die App des Modellherstellers (Midjourney, Google Flow, Kling, Runway), Design-Tools mit eingebauter KI (Canva, Adobe Firefly) und Multi-Modell-Plattformen (Krea, Higgsfield, OpenArt, LUVI Creator).
Suno v6 liefert zwei Takes für 264 Credits, MiniMax Music 2.6 und 3.0 einen Track für 300, auch als WAV. Für ein Bett unter dem Clip zählt vor allem der Instrumental-Schalter: MiniMax legt ihn um, sobald im Prompt instrumental steht, Suno v6 nicht.
Acht Stimmmodelle auf LUVI, und die meisten rechnen pro Zeichen ab, ohne Aufrundung auf Blöcke: derselbe Absatz mit 311 Zeichen lag bei einem bei 10 Credits und bei einem anderen bei 63. Eines rechnet nach Minuten, und seine Schätzung ist eine Zwei-Minuten-Reservierung.
Einen Clip auf LUVI hochzuskalieren wird pro Sekunde Ausgangsvideo abgerechnet: 36 Credits je Sekunde auf 1080p, 48 auf 2K. Damit ist in der günstigsten Auflösung zu generieren und danach hochzuskalieren deutlich billiger — es fügt allerdings Pixel hinzu, keine Details.
Sobald ein Assistent einen Ordner für dich löschen kann, taugt der Bestätigungsdialog nicht mehr als Netz. LUVIs Antwort war, das Löschen um 24 Stunden zu verschieben – und den Inhalt des Ordners genau dort zu lassen, wo er war.
Vier Modelle auf LUVI verlängern einen Clip, den du schon hast. Auf derselben Quelle von zehn Sekunden lagen fünf zusätzliche Sekunden bei einem bei 450 Credits und bei einem anderen bei 4510. Die Schreibregel ist überall dieselbe: Schreib nur, was als Nächstes passiert.
Der Name Grok Imagine umfasst auf LUVI drei Bildmodelle und eine Videoreihe, und sie sind keine Versionen voneinander. Zwei nutzen entgegengesetzte Referenzsyntax, nur eines erreicht 2k, und nur die Videoreihe erzeugt Ton. Ab 40 Credits je Bild.
Image 2.0 liest den Prompt als Spezifikation und baut daraus eine typografische Hierarchie. Die Art des Stücks und die Textebenen zu benennen bringt mehr als jeder Stapel Adjektive. Es ist zudem eine eigene Familie neben den älteren Grok-Bildmodellen. Ab 80 Credits je Bild.
Alle 45 Videomodelle auf LUVI, die ein Bildformat zur Wahl stellen, bieten 9:16. Die übrigen 94 legen es woanders ab: in einem Parameter, in einer Pixelgröße oder in deinem Referenzbild. Die Länge reicht von 5 bis 30 Sekunden pro Generierung.
Transkribieren, neu schreiben, sprechen lassen, den Mund neu synchronisieren. Jeder Schritt ist ein eigenes Modell, und der letzte macht die Rechnung: Zwei Lipsync-Modelle lagen bei 130 und 2200 Credits für denselben Clip von zehn Sekunden.
Qwen-Image ist darauf gebaut, Text zu setzen: Jede sichtbare Zeichenfolge steht in Anführungszeichen und bekommt eine Position. Verneinungen im Prompt-Text werden nicht gelesen, manche Modelle haben ein eigenes Feld. Ein Bild lag auf Max bei 105 Credits.
Hailuo nimmt die Kamera als Befehl in eckigen Klammern aus einer geschlossenen Liste von fünfzehn. Auf MiniMax H3 sind diese Klammern tote Syntax, dort gehört die Kamera in Prosa. Einen Prompt von der einen in die andere Reihe zu kopieren verliert die gewünschte Bewegung lautlos.
Bei GPT Image 2.5 sind Prosa und Referenzbilder die gesamte Steuerung: kein Seed, kein Feld für einen negativen Prompt, kein Stilregler. Die Qualitätsstufe bewegt den Preis weit stärker als die Pixel — ein Bild in 4K auf mittlerer Stufe lag unter einem 1024-Pixel-Bild auf hoher.
Von LUVIs 224 öffentlichen Modellen nehmen 99 überhaupt kein Referenzbild. Der Rest reicht von einem einzigen Bild bis zu dreißig bei einem Modell, und 24 Bild-zu-Video-Modelle tragen einen optionalen Platz für das Schlussbild.
Bei Vidu Q3 ist der Stil-Regler laut Dokumentation wirkungslos, Look und Bewegungsenergie stehen also im Satz. Das Seitenverhältnis startet außerdem in 4:3, nicht in 16:9. Fünf Sekunden lagen in 720p bei 510 Credits auf Q3-Turbo und 1063 auf Q3-Pro.
Die meisten Videomodelle auf LUVI haben keinen Seed, zwei identische Anfragen liefern also zwei verschiedene Personen. Die Identität steckt in den Referenzplätzen, und jede Familie benennt sie anders. Wie viele Referenzen jede nimmt und wie man Einstellung an Einstellung hängt.
Grok Imagine Video erzeugt Bild und Ton im selben Durchgang und hat keinen Schalter, um den Ton abzustellen. Ein Prompt, der seinen Ton nicht benennt, bekommt den, den das Modell erfindet. Verneinungen werden hier ebenfalls überlesen. Acht Sekunden in 720p lagen bei 1120 Credits.
Vier Bildfamilien im LUVI-Katalog bringen echte Wörter ins Bild, und jede will die Anfrage anders formuliert: eine Oberfläche, eine Hierarchie, eine eigene räumliche Auflage oder eine Position samt Gestaltung. 30 bis 144 Credits je Bild.
Ein PixVerse-Prompt besteht aus drei Sätzen: Motiv und eine Aktion, dann eine Kamerabewegung mit benanntem Licht und Objektiv, dann die Auflagen als das, was heil bleiben soll. Vier verbreitete Wörter arbeiten gegen dich. Fünf Sekunden in 720p lagen bei 600 Credits.
Der LUVI-Connector gibt Claude oder ChatGPT 35 Werkzeuge auf deinem eigenen Konto: den Modellkatalog lesen, das Handbuch einer Familie holen, einen Preis schätzen, generieren und melden, was die Generierung tatsächlich gekostet hat. Wofür jede Gruppe da ist und was sie bewusst nicht kann.
Hailuo nimmt die Kameraführung als Befehl in eckigen Klammern entgegen, aus einer geschlossenen Liste von fünfzehn, gesetzt an die Stelle, an der die Bewegung passiert. Das Modell erzeugt nur Bild: Jedes Wort über Ton ist verschenkt. Sechs Sekunden beginnen bei 380 Credits.
Aus einem Skript eine Moderation zu machen sind zwei Generierungen: Ein Stimmmodell liest den Text, ein Lipsync-Modell legt diesen Ton auf ein Gesicht. Der Stimmschritt ist billig genug für zehn Versuche, der Gesichtsschritt nicht. Hier steht die Reihenfolge, die Credits spart.
Wan 3.0 liest eine Formel, die sich aufbaut: Motiv, Schauplatz, Bewegung, dann die Optik, dann der Ton. Den Ton generiert es im selben Durchgang. Benennst du die Kamera nicht in jeder Einstellung, schneidet das Modell mitten in den Clip, den du als eine Einstellung wolltest.
LUVI hat sechs Lipsync-Familien, und sie erledigen zwei verschiedene Aufgaben: Vier animieren ein Standbild aus einer Tonspur, zwei synchronisieren den Mund in einem Video, das du schon hast. Welche Aufgabe es ist, entscheidet auch, welche Uhr abgerechnet wird.
In den Bild-zu-3D-Modi von Hunyuan3D wird das Textfeld gar nicht gelesen: Der Modellvertrag sagt, dass kein Prompt angenommen wird. Deine gesamte Kontrolle steckt darin, wie du das Eingabebild vorbereitest. Meshes starten bei 600 Credits auf Rapid und 1000 auf Pro.
Der Feder-Button neben dem Prompt lässt das Handbuch der jeweiligen Familie über deinen Text laufen, kostenlos. Er hat zwei Schichten: acht deterministische Prüfungen, die nur bei Belegbarem anschlagen, und eine Dialekt-Korrektur für alles, was Ermessen verlangt.
Seedream 5.0 Pro hat keinen Parameter für das Seitenverhältnis. Die Form steckt in size, geschrieben als BREITE*HÖHE mit Sternchen; ein Verhältnis im Text wird ignoriert. Hier stehen die dreizehn gültigen Größen, der thinking-Schalter und der Satzbau, den das Modell belohnt.
Vier der 224 Modelle im LUVI-Katalog haben ein Feld für einen negativen Prompt, und alle vier gehören zu Qwen Image. Das Feld verschwand mit dem Sampling-Verfahren, auf dem es beruhte. Was in jeder Familie an seine Stelle tritt, und die drei Stellen, an denen „no X“ weiterhin greift.
Eine Multi-Modell-KI-Plattform bündelt Video-, Bild-, Audio- und 3D-Modelle vieler Anbieter in einem Arbeitsbereich mit einem Guthaben. Worauf es bei der Wahl ankommt: genaue Modellversionen, ein Preis vor jeder Generierung und Hilfe beim Prompten für jedes einzelne Modell.
Higgsfield, Krea, OpenArt und LUVI Creator betreiben gehostete MCP-Connectors, über die Claude oder ChatGPT auf deinem Konto generieren. Die Unterschiede: wie du den Preis vor der Generierung siehst, wie viele Modelle erreichbar sind und ob der Assistent den Prompt-Leitfaden jedes Modells bekommt.
Nano Banana Pro erzeugt bei jeder Bearbeitung das ganze Bild neu. Eine Anweisung ohne Erhaltungssatz verändert deshalb Dinge, nach denen du nie gefragt hast. Sag, was sich ändert und was bleibt, und sprich Referenzen als Image 1 an. Bearbeitung ab 175 Credits in 1k.
Die meisten Videomodelle auf LUVI erzeugen den Ton inzwischen im selben Durchgang wie das Bild, sind sich sonst aber über fast nichts einig: ob der Schalter an ist, ob er extra kostet und wie du den Ton schreibst. Hier stehen Schalter und Syntax jeder Familie, gegen ihre Schemata geprüft.
HappyHorse erzeugt Bild und Ton zusammen, leitet den Ton aber nicht aus dem Bild ab: Ein Prompt ohne Audiozeile liefert ein fast stummes Video. Außerdem gehört das Modell zu den wenigen, die Zeitmarken pro Einstellung einhalten – genau umgekehrt zu Seedance 2.5.
FLUX 3 Video erzeugt Bild und Ton in einem Durchgang. Der Ton wird deshalb in den Prompt geschrieben und nicht per Schalter zugeschaltet. Setz jede Replik in Anführungszeichen und gib ihr jemanden im Bild, der sie sagt, sonst kann sie als Text im Bild erscheinen. Ab 1870 Credits auf LUVI.
Eine Einstellung schreibst du bei Kling 3 in dieser Reihenfolge: Subjekt, Bewegung, Schauplatz, danach Kamera, Licht und Atmosphäre. 60 bis 100 Wörter, eine Kamerabewegung, eine Handlung. Der ganze Prompt ist bei 2.500 Zeichen gedeckelt, und darüber scheitert schon das Absenden.
Kommt bei Veo 3.1 kein Ton, ist auf LUVI meist die Audiogenerierung aus: standardmäßig deaktiviert, bei Veo 3.1 Lite gar nicht vorhanden. Den Prompt baust du von der Kamera her auf, Dialog und Geräusche gehören in die Szene. Ein 8-Sekunden-Clip in 720p kostet ab 800 Credits.
Seedance 2.5 liest Zeitmarken in ganzen Sekunden, typisierte Audiokanäle und eine Kamerabewegung pro Einstellung. Die meisten schlechten Ergebnisse entstehen, weil das Modell wie Seedance 2.0 gepromptet wird. Hier ist die Struktur, die funktioniert – aus dem Leitfaden, den wir in LUVI einsetzen.
Alle drei erzeugen Bild und Ton in einem Durchgang, und alle drei lesen einen Prompt anders: H3 will ein Dokument mit Feldern, Omni eine Bildbeschreibung mit Kontinuitätsklausel, Wan eine additive Formel. Preise, Grenzen und die eine Regel, an der jedes von ihnen scheitert.
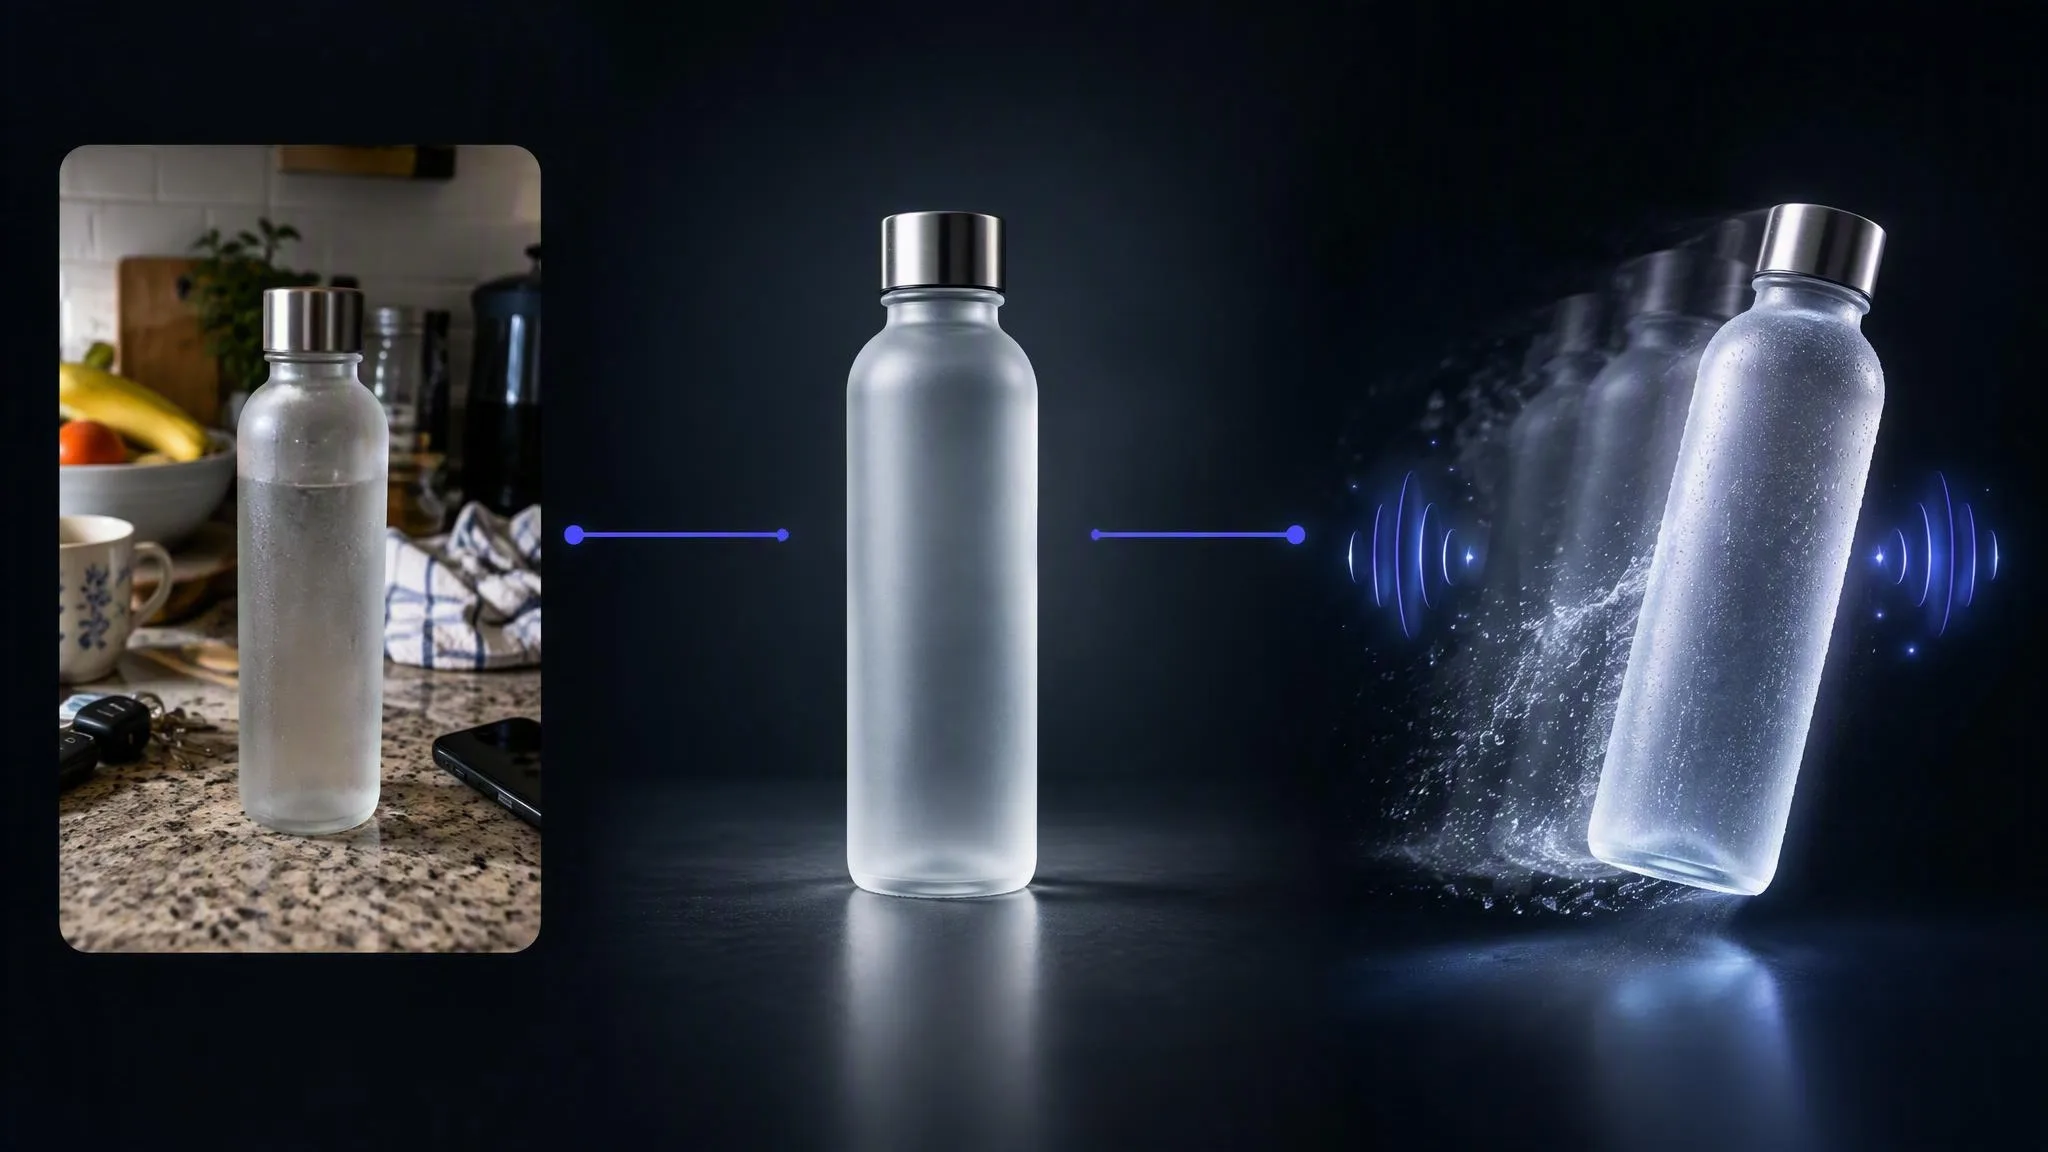
Aus dem Handyfoto einer Flasche wird mit Nano Banana Pro ein sauberes Studiobild und daraus mit Seedance 2.5 ein Fünf-Sekunden-Clip mit Bewegung und Ton – als ein Workflow verdrahtet, vor dem Start geschätzt, ab etwa 3.200 Credits.
Vor jeder Generierung zeigt LUVI eine Schätzung in Credits, abgebucht wird erst mit dem Ergebnis – nach dem, was der Auftrag tatsächlich verbraucht hat, und nie mehr als die Schätzung. Was sich geändert hat, was wir gemessen haben und warum ein Modell von 15 auf 7 Credits fiel.
iPhone-HEIC scheiterte in Chrome, WebP brachte die Hälfte der Modelle durcheinander, ein Browser-Decoder brauchte 27 Sekunden für 12 Megapixel. Also läuft die Umwandlung jetzt auf dem Server, mit einer Regel: Jedes Bild wird als JPEG oder PNG gespeichert, Farbprofil und Ausrichtung bleiben erhalten.